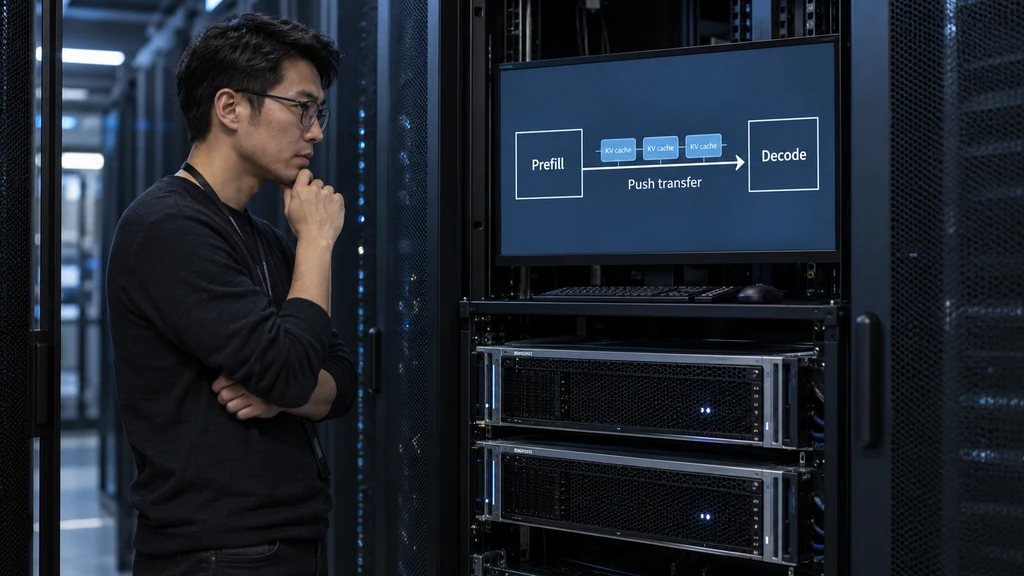
vLLM popsalo nový režim přenosu KV cache mezi odděleným zpracováním vstupu a generováním odpovědi. Push konektor NIXL připraví cílovou paměť před dokončením výpočtu vstupu a odešle data z producentské strany na pozadí. Tím omezuje čekání před prvním tokenem i práci v citlivé smyčce generování. V testu modelu Qwen3-32B na dvou uzlech Amazon EC2 P5en s propojením EFA dosáhl až přibližně trojnásobného zlepšení času k prvnímu tokenu a až třicetiprocentního zlepšení času na výstupní token. Výsledky závisí na zátěži a konfiguraci; při malé zátěži byly rozdíly minimální. Push navíc vyžaduje dřívější výběr generujícího uzlu, zatímco původní pull režim zachovává pružnější směrování po zpracování vstupu.