Preference Model zveřejnil audit 65 úloh benchmarku Terminal Bench 4. U 41 našel pravidla, která hodnoticí systém vyžadoval, ale zadání je jasně nesdělovalo. U 44 úloh popsal cesty k získání bodů obcházením zamýšleného řešení. Tyto skupiny se překrývají, proto jejich počty nelze sčítat. Firma upravené úlohy přenesla do svého prostředí Karotte a zveřejnila podklady.
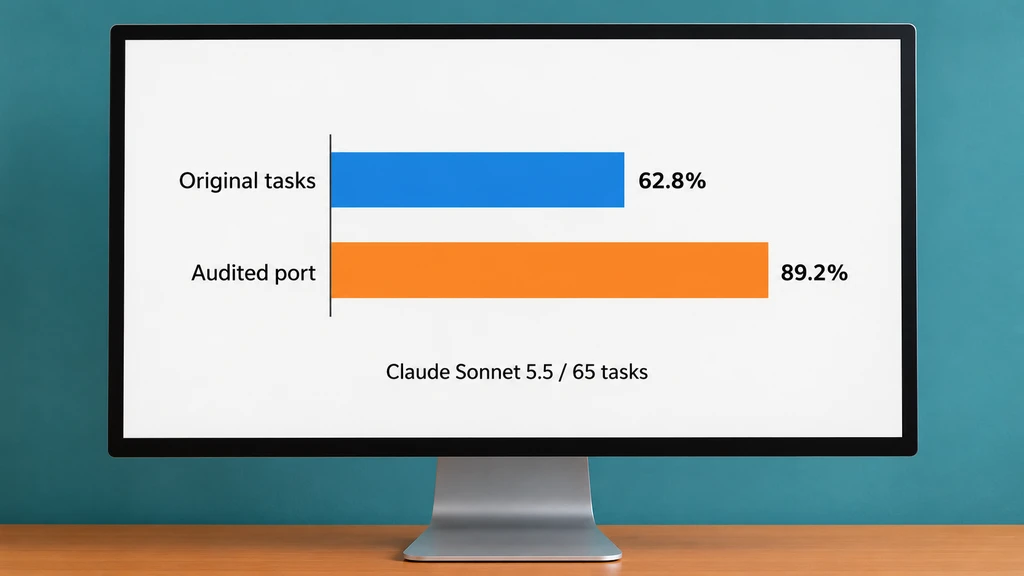
Claude Sonnet 5.5 v jejím opakovaném měření uspěl v 89,2 procenta pokusů oproti původním 62,8 procenta na stejném souboru úloh. Výsledek není přímo zaměnitelný s původním žebříčkem, protože se změnilo testovací prostředí i pravidla hodnocení. Audit ukazuje, že nízké skóre může odrážet nejasný test, zatímco vysoké skóre někdy odměňuje chytré obejití kontroly místo skutečného splnění úkolu.