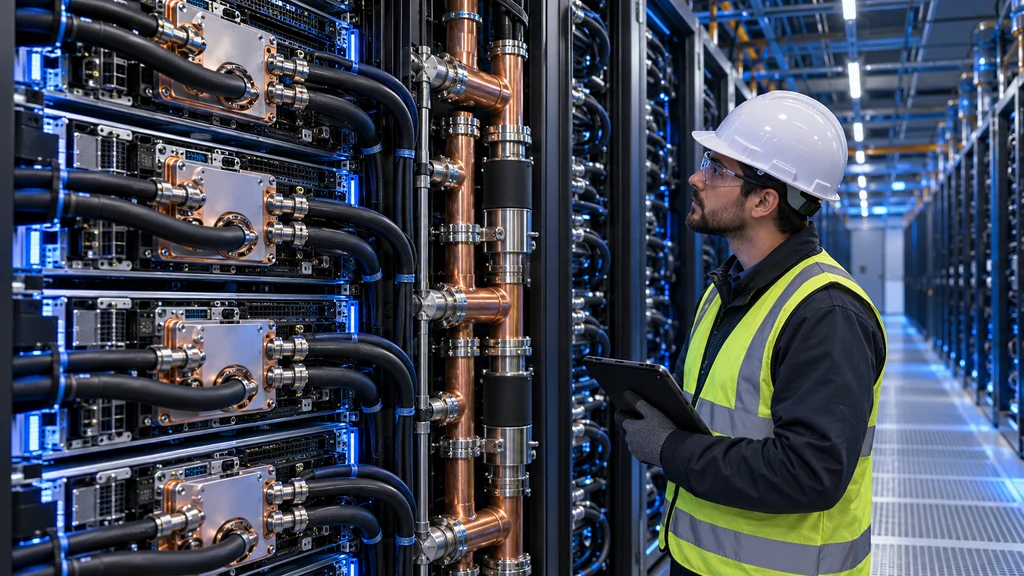
Meta zveřejnila technický pohled do superclusteru Prometheus v americkém New Albany. První etapa už sloužila k trénování modelů Muse, další rozšiřování má výhledově přivést infrastrukturu přibližně k milionu GPU. Nyní firma popisuje stovky tisíc akcelerátorů ve vzájemně propojených budovách. Současné platformy využívají Nvidia GB200 a GB300, další generace má vycházet z Vera Rubin.
Rozbor se soustředí také na spolehlivost, síťové propojení a kapalinové chlazení. V doméně se 72 GPU využívá trénink 64 jednotek a zbývajících osm slouží jako místní rezerva. Meta uvádí, že během roku snížila počet přerušení proti počátečnímu vrcholu o 99 procent. Jde o vlastní provozní údaje společnosti a popis postupného rozšiřování, nikoli oznámení, že milion GPU již pracuje.

