Hamel Husain a Antaripa Saha zveřejnili srovnání rozhodovacích modelů pro hledání chyb v konverzacích AI asistenta pro pronájem bytů. Z původní stovky záznamů hodnotili 98 po vyloučení dvou interních testů. Porovnávali Jev, Perplexity Decider, Liquid d1 a d1-ultra, Cloudflare Clef Flash a OpenAI Decisions. Výsledky poměřovali s ručně ověřenými štítky.
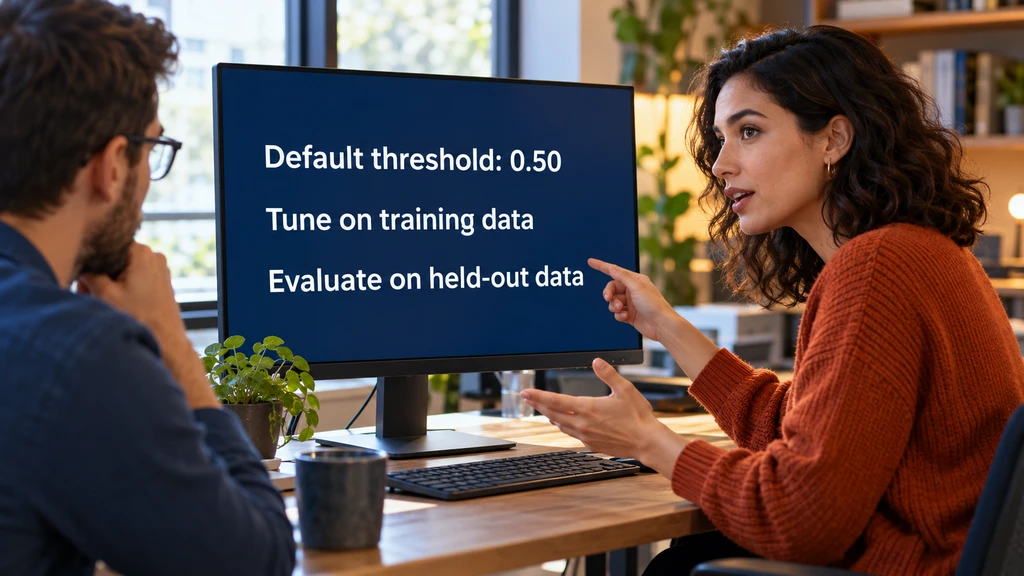
Experiment ukazuje, že výchozí rozhodovací práh 0,50 nemusí vyhovovat konkrétním datům. Autoři proto ladili práh na trénovací části a výsledky kontrolovali na oddělených záznamech. V tomto úkolu dosáhlo OpenAI Decisions vyššího skóre F1 než levnější Perplexity; nejde však o obecný žebříček kvality. Vedle nákladů je nutné sledovat falešné poplachy, zachycené chyby a kalibraci pravděpodobností. Samotné číslo 0,80 ještě nezaručuje, že chyba skutečně nastane v osmi z deseti případů.