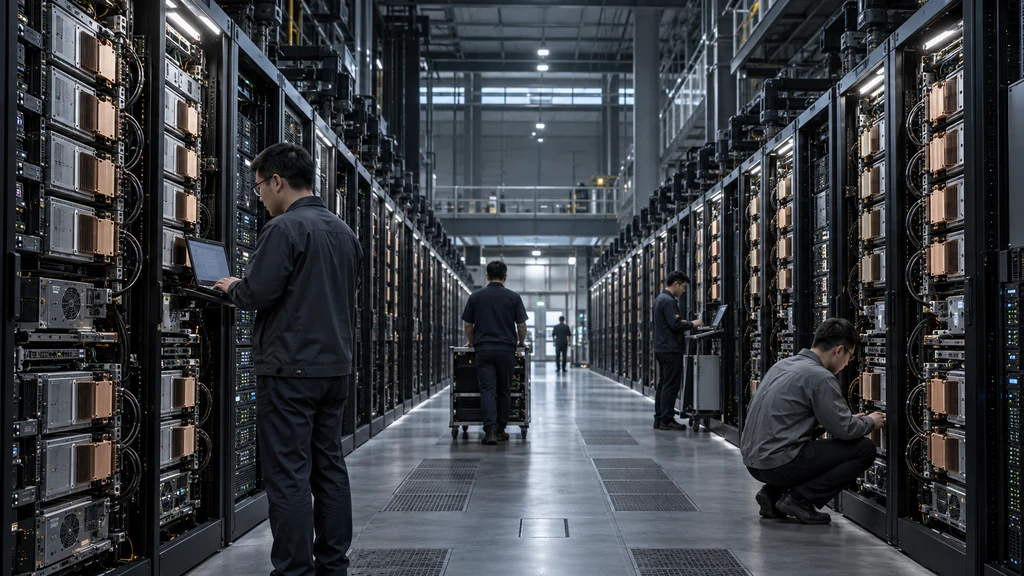
GLM-5.3-Flash dostal produkční inferenční systém vybudovaný od nuly na clusteru s více než 100 000 čínskými akcelerátory. Systém musel zvládnout novou architekturu modelu, multimodální požadavky i kontext dlouhý jeden milion tokenů, přestože ekosystém čipů měl omezenou paměť a neúplnou podporu jader. Vývojáři do něj zapojili takzvaného Infra Agenta poháněného samotným GLM. Ten analyzoval výsledky testů, navrhoval změny a pomáhal optimalizovat běh. Kombinace paralelismu, kvantizace paměti a odděleného zpracování vstupu, předvýpočtu a generování zvýšila propustnost zhruba trojnásobně. Od prvního přizpůsobení modelu k produkčnímu nasazení uplynuly necelé dva týdny. Autoři popisují ranou podobu rekurzivního sebezdokonalování, nikoli však plně autonomní návrh a trénink nástupce.