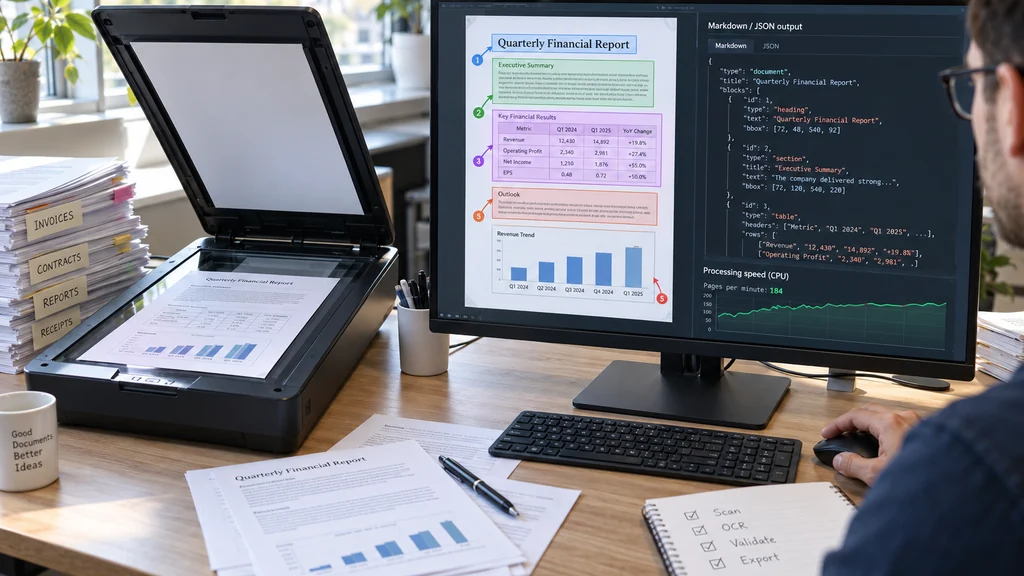
Datalab vydal Indra OCR, balíček pro rozpoznávání textu postavený kolem 1Mparametrového modelu. Firma uvádí, že na 32 CPU jádrech čte 49 stran za sekundu, má přibližně 230 milisekund latence na jednu stránku a v jejích měřeních běží 11 až 17krát rychleji než textové modely Tesseract a PaddleOCR PP-OCR. Kromě textu má nástroj vracet i layout dokumentu: ohraničení řádků a bloků, štítky pro nadpisy, seznamy, tabulky či popisky a pořadí čtení ve výstupu Markdown nebo JSON. Datalab tvrdí, že Indra OCR poráží srovnávané alternativy také na textové části benchmarku OmniParseBench. Balíček cílí hlavně na digitalizované a skenované dokumenty, kde je důležitá rychlost na CPU.