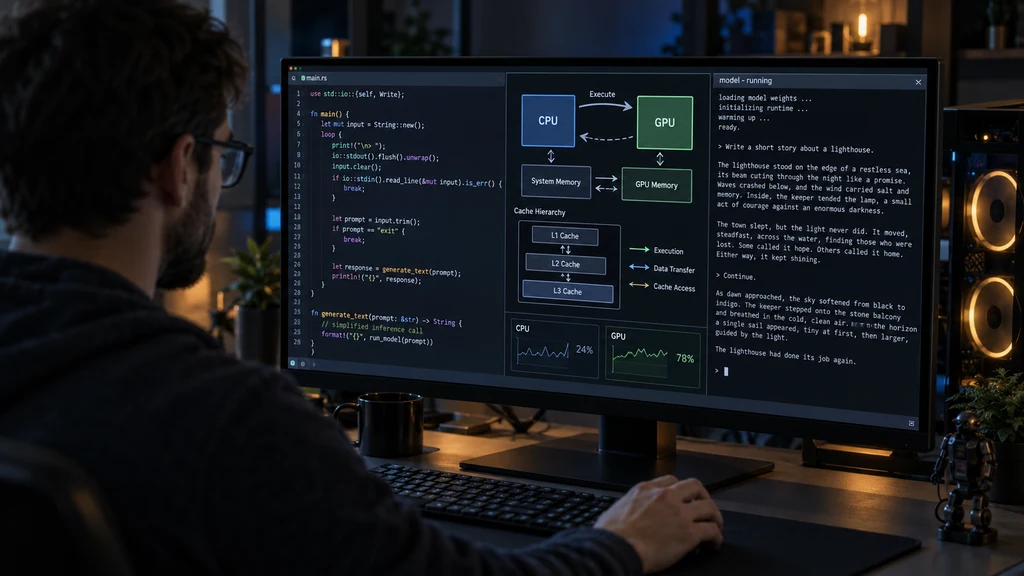
Enki LLM je malý inferenční engine napsaný v Rustu, který demonstruje přesun výpočtu mezi grafickým procesorem a CPU během generování textu. Implementace má přibližně dva tisíce řádků kódu a zahrnuje vlastní komponenty pro načítání vah, tokenizaci i výpočet modelu. Projekt využívá runtime Enki a Vulkan místo závislosti na CUDA.
Ukázka pracuje s modelem Llama 3.2 1B a přesouvá také KV cache, aby generování mohlo pokračovat se zachovaným kontextem. Autor uvádí přibližně 40 tokenů za sekundu na Nvidia Tesla T4; nejde o nezávisle ověřený benchmark. K dispozici je notebook pro vyzkoušení v Colabu. Praktickou zajímavostí je především demonstrace přenosu běžící inference, ne nový jazykový model.