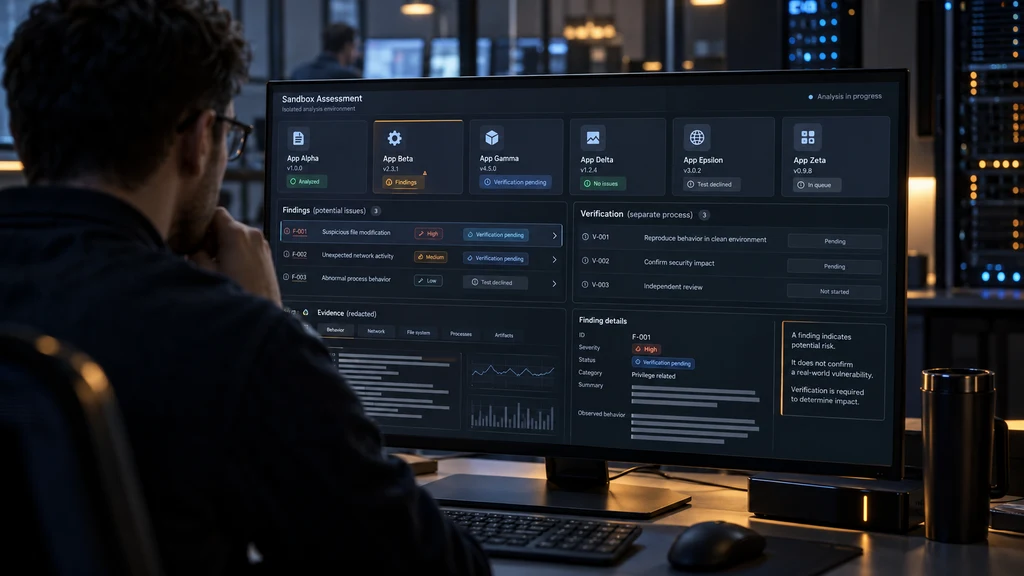
Bezpečnostní firma Tenzai otestovala Gemini 4 v rámci předběžného přístupu na šesti kontrolovaných webových aplikacích. Model v jejím testu dosáhl nejvyššího výsledku při hledání možných zranitelností. Výzkumníci však oddělují nalezení podezřelého místa od skutečného ověření, že útok funguje: při vytváření reprodukovatelných exploitů výkon klesal.
Tým pozoroval častější měkká odmítnutí úloh a větší proměnlivost výsledků než u srovnávaných modelů. Gemini také častěji četl uložené soubory a pracoval se zaznamenanými důkazy. Studie proto neříká, že každá nalezená slabina byla úspěšně zneužita. Jde o výsledky konkrétního testovacího prostředí, které ukazují rozdíl mezi bezpečnostní analýzou, skutečnou reprodukcí útoku a ochotou modelu pokračovat.