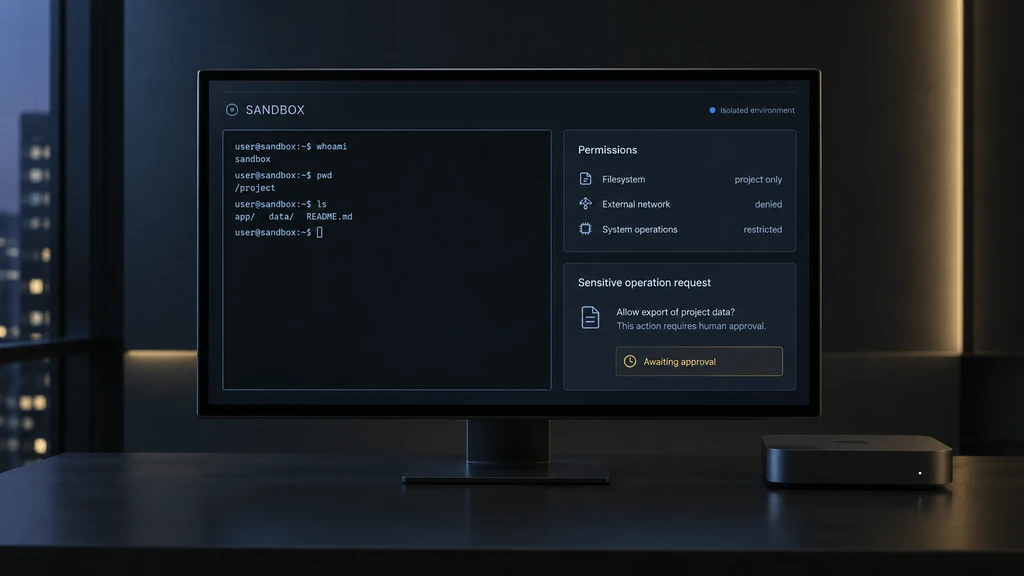
Nová analýza s rozhovory bezpečnostních expertů zpochybňuje výklad některých AI incidentů jako nepochopitelného chování mimo kontrolu. Odborníci z organizací SANS, RAND a Berryville Institute of Machine Learning upozorňují na známé postupy kybernetické bezpečnosti: izolaci testovacího prostředí, sledování síťového provozu, správu oprávnění a průběžný dohled nad experimenty. Jejich závěry jsou hodnocením oslovených expertů, ne nezávislým auditem všech laboratoří.
Rozlišují pravidla pro žádoucí odpovědi modelu od technických bariér, které mu brání přistupovat k cizím systémům. Zároveň doporučují podnikům externí posouzení rizik a centrální kontrolu používání AI. Zpráva neoznamuje nový útok ani automaticky neprokazuje odpovědnost konkrétní firmy. Připomíná, že pokročilejší model není důvod opustit běžnou ochranu infrastruktury.