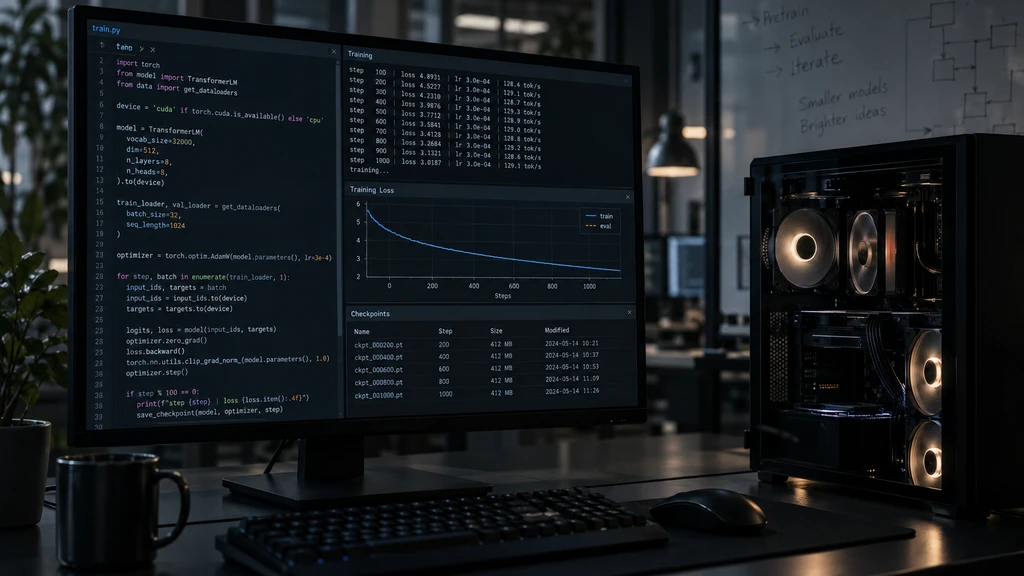
Projekt Build-GPT-2 ukazuje celý postup trénování modelu se 124 miliony parametrů v PyTorchi. Obsahuje přípravu dat FineWeb-Edu, distribuované učení na více GPU, validaci, generování textu a obnovu po přerušení. Autor u zveřejněného běhu uvádí 2,48 miliardy trénovacích tokenů, čtyři karty NVIDIA A40 a dobu 2,8 hodiny. K dispozici jsou také výsledné váhy a úplný trénovací log.
V normalizované metrice HellaSwag dosáhl model 27 procent proti 29,55 procenta referenčního GPT-2 stejné velikosti. Dokumentace otevřeně popisuje plynulý, ale nespolehlivý generovaný text. Jde o výukovou a technickou reprodukci starší architektury, nikoli nový špičkový model od OpenAI. Uložené kontrolní body zahrnují také stav optimalizátoru a čtení dat, aby bylo možné pokračovat v běhu.