
Umělá inteligence se v reklamách tváří jako software, který se učí sám. Ve skutečnosti za jejími odpověďmi stojí dlouhý řetězec lidí, firem a levné práce, který se obvykle ztratí někde mezi datacentrem a hezkou ukázkou nového modelu.
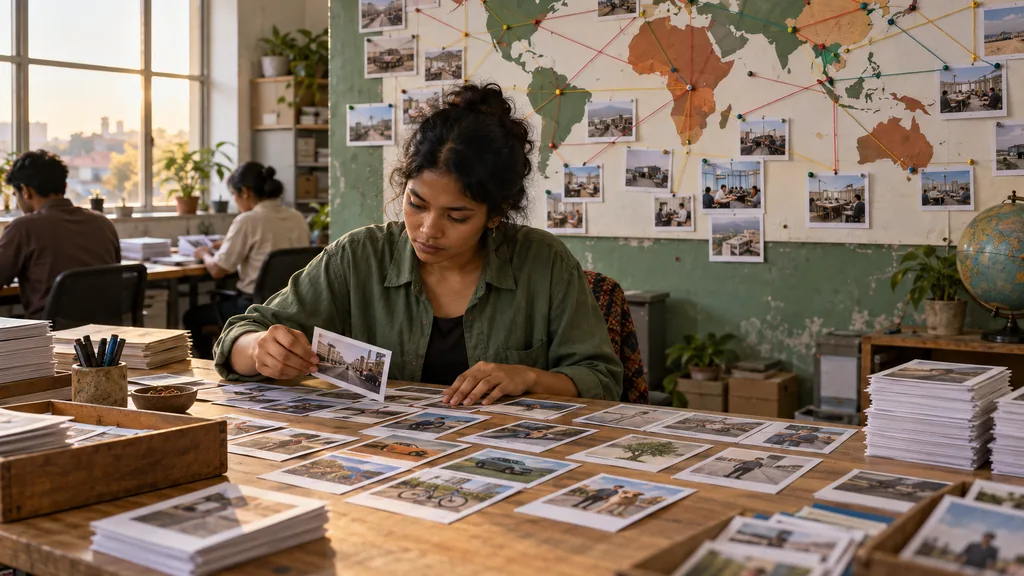
Čerstvá Rychlá zpráva o mapě globální práce za AI popisuje projekt studentky Cunyan Ma z Brownovy univerzity. Původní článek Brownovy univerzity ukazuje, jak se dají propojit technologické firmy, prostředníci a místa, kde lidé data skutečně připravují.
Nejde o dokonalý registr celého odvětví ani o audit každé firmy. Právě proto je ale mapa zajímavá: místo dalšího obdivování modelu nutí podívat se na pracovní řetězec, bez kterého by žádný model neměl co číst, porovnávat ani odmítat.
Algoritmus začíná u člověka s úkolem
Aby se model naučil rozpoznat objekt na fotografii, přepsat řeč, ohodnotit odpověď nebo najít hranici nádoru na snímku, někdo musí připravit příklady a zkontrolovat jejich význam. V technickém jazyce se tomu říká anotace dat. Pro uživatele je to neviditelná vrstva, pro provozovatele modelu jedna z podmínek, bez nichž se z hromady souborů nestane použitelný tréninkový materiál.
Část této práce je rutinní. Část ale znamená číst nebo sledovat obsah, který by většina lidí dobrovolně neotevřela. Brownův článek popisuje také úkoly spojené s filtrováním násilného a sexuálně zneužívajícího obsahu, protože bezpečnostní systém musí takový materiál nejprve poznat, aby ho dokázal zachytit.
To je nepříjemný paradox bezpečnější AI. Čím více chceme, aby model odmítal nebezpečný obsah, tím více někdo musí vytvořit nebo projít příklady toho, co má být odmítnuto. V rozhraní chatbota se objeví krátká věta o bezpečnosti, ale za ní může být několik hodin práce člověka, který žádný chatbot nepoužívá.
Mapa kreslí síť, ne pohádku o samostatném modelu
Cunyan Ma propojila existující databáze firem zaměřených na datové práce a jejich korporátní zákazníky s vlastním přehledem doručovacích center. Umístění center je v mapě použito jako přibližný obraz toho, kde se pracovníci nacházejí, nikoli jako přesný seznam každého člověka nebo každé zakázky.
Současná verze podle Brownovy univerzity ukazuje vazby mezi 13 společnostmi pro označování dat, 141 jejich firemními zákazníky a 31 zeměmi, v nichž se nacházejí pracoviště datových pracovníků. Tato čísla jsou užitečná jako mapa mocenských a obchodních vztahů, ne jako měření celého trhu.
Autorka sama projekt označuje za ilustrativní a chce ho dál rozšiřovat. To je důležitá hranice. Mapa může ukázat, že řetězec existuje, a přivést čtenáře ke konkrétním vazbám; sama ale neřekne, kolik přesně kdo vydělává, jaké má smluvní podmínky nebo jak se v jednotlivých centrech řeší psychická zátěž.
Na stránce Data Work Landscape je vidět i další důležitá věc: data o tomto odvětví nejsou přirozeně vystavena v jedné veřejné tabulce. Část informací vzniká z firemních databází, část z novinářských zpráv a část z vlastního dohledávání. Už samotná roztříštěnost je důvodem, proč se odpovědnost snadno rozpustí mezi objednatele, dodavatele a subdodavatele.
Nejlevnější článek řetězce bývá nejméně vidět
Brownův text spojuje tuto práci hlavně se zeměmi globálního Jihu, například s Keňou, Indonésií a Kolumbií. Neznamená to, že každý pracovník v těchto zemích dělá stejnou práci nebo že každý kontrakt má stejné podmínky. Znamená to, že velká část odvětví hledá práci tam, kde je levnější a kde má pracovník menší vyjednávací sílu.
Na Radyzu jsme nedávno popsali jinou, názornou podobu stejného principu: indické pracovníky, kteří natáčejí vlastní profesní činnosti jako data pro roboty. Tady nejde o moderování obsahu, ale o sběr pohybů pro fyzickou AI. Společný je fakt, že technologický produkt může působit jako čistý software, i když jeho vývoj závisí na velmi konkrétní směně člověka.
V debatě o bezpečnosti se často používá anglické označení human-in-the-loop, člověk ve smyčce. Zní to jako technická pojistka, ale bez otázky, kdo ten člověk je, kolik dostane, jakou má podporu a kdo nese odpovědnost za jeho práci, jde jen o další zkratku, která schová skutečný provoz.
Největší problém proto není jen nízká mzda. Je to také odstup mezi člověkem, který úkol provádí, firmou, která práci zadává, a veřejností, která pak používá výsledek. Když se model splete, je snadné ukázat na model. Mnohem těžší je dohledat, kdo nastavil pravidla, podle nichž člověk data připravoval.
Číslo o obratu neříká nic o ceně lidské práce
Trh s přípravou dat přitom rozhodně není malý doplněk k vývoji modelů. Starší zpráva o firmě Micro1 a jejím růstu v datových službách ukazuje, jak velké peníze se kolem tréninkových dat mohou točit. Firemní obrat ale není výplatní páska pracovníka a rychlý růst prostředníka sám o sobě neříká nic o kvalitě podmínek na posledním článku řetězce.
Právě tady se veřejná debata často zadrhne. Když firma oznámí vyšší poptávku po datech, mluví o odbornících, škálování a kvalitě. Když se stejná práce objeví v reportáži, náhle vidíme člověka, který tráví hodiny u monotónního nebo psychicky náročného úkolu. Obojí je součást stejného obchodu, jen každá strana používá jiný slovník.
Mapa Brownovy studentky proto není jen obrázek s body na mapě. Je to pokus spojit jazyk technologického průmyslu s jazykem práce. Firma není pouze zákazník, dodavatel není pouze API a pracovní místo není pouze anonymní souřadnice, kterou lze schovat v prezentaci o efektivitě.
AI kolonialismus je rámec, ne neutrální technický termín
Ma svůj projekt popisuje jako vizualizaci takzvaného AI kolonialismu. Ten pojem není měřením ani oficiální klasifikací trhu; je to kritický rámec, který upozorňuje na přesun obtížné a levně placené práce z chudších částí světa k hodnotě vytvářené hlavně pro bohatší zákazníky.
Je fér ten rámec nepřevádět na univerzální verdikt o každé firmě a každém pracovníkovi. Zároveň by byla chyba ho odmítnout jen proto, že technologie zní moderně. Pokud objednatel ví, že data připravují lidé v jiných zemích, ale nechce vědět, v jakých podmínkách pracují, nejde o technickou slepotu. Je to obchodní rozhodnutí.
Brownův profesor Suresh Venkatasubramanian v článku připomíná, že AI je ve skutečnosti souhrnem lidského poznání, práce a úsudku. To není poetická poznámka pod čarou. Je to přesnější popis systému než představa, že model sám objevil znalosti, které pak velkoryse rozdává světu.
Odpovědnost se nesmí ztratit mezi třemi firmami
Historie podobných služeb ukazuje, že outsourcing není novinka. Mechanical Turk kdysi udělal z lidských mikroúkolů infrastrukturu dostupnou na kliknutí. Dnešní datové firmy pracují s pokročilejšími úkoly a často s odbornějšími pracovníky, ale základní otázka zůstává: kdo je vidí jako součást produktu a kdo jen jako nákladovou položku?
Technologická firma může tvrdit, že práci zadala specializovanému dodavateli. Dodavatel může ukázat na subdodavatele. A subdodavatel může říct, že pouze plní specifikaci. Pro pracovníka se tím ale odpovědnost nezmenší; jen se prodlouží cesta k člověku, který má pravomoc něco změnit.
Kdo chce AI používat odpovědně, měl by se proto ptát na mnohem méně efektní věci než na počet parametrů modelu. Kdo data označuje? Kde se práce provádí? Jak se chrání lidé před opakovaným vystavením škodlivému obsahu? Jak se hlídá kvalita a jak se řeší stížnost pracovníka, když pravidla nastavila firma na druhém konci světa?
To nejsou otázky proti inovaci. Jsou to otázky proti pohodlné iluzi, že inovace začíná až u modelu. Model je poslední viditelná vrstva. Před ním je pracovní provoz, který si zaslouží stejnou pozornost jako server, rozhraní nebo marketingová ukázka.
Bez lidí za mapou neuvidíme, co AI skutečně stojí
Největší hodnota projektu z Brownu není v tom, že by jedním grafem spočítal celý svět práce pro AI. Takový slib by byl přehnaný. Je v tom, že propojuje firmy a místa, která se v běžném vyprávění o umělé inteligenci objevují odděleně, a ukazuje, že mezi datovým centrem a odpovědí chatbota existuje dlouhý lidský provoz.
Budoucí verze mapy může přidat další firmy, další země nebo také polovodičový průmysl, který Ma chce sledovat. Ani pak ale nepůjde jen o technickou databázi. Každý nový bod bude otázkou, kdo ho tam umístil, z jakého zdroje pochází a zda za ním stojí pracovník, jehož práce má být konečně vidět.
AI se tedy netrénuje sama. Trénují ji lidé, často mimo zorné pole zákazníka a někdy i mimo zorné pole firmy, která se chlubí výsledným produktem. Dokud tuto práci budeme označovat jen jako data, modely a infrastrukturu, budeme mluvit o umělé inteligenci bez lidí, kteří jí dali schopnost vůbec něco dělat.