OpenAI rozšiřuje rodinu GPT-6 o dvojici modelů, které míří na mnohem větší objem práce než vlajková loď GPT-6 Astra. GPT-6 Sol má být volbou pro složitější programování a agentní workflow, GPT-6 Luna zase pro levné a rychlé úlohy ve velkém. Hlavní zpráva není jen vyšší skóre v testech. OpenAI současně výrazně snižuje cenu používání.
Modely Sol a Luna navazují na oznámení, o kterém jsme psali v rychlé zprávě o rozšíření GPT-6. Tentokrát je ale zajímavější než samotné vydání otázka, co s novou dvojicí udělá cena agentních aplikací. Pokud budou modely dostatečně spolehlivé, vývojáři je nebudou nasazovat jen jako levnější chatboty, ale jako pracovní vrstvu běžící v desítkách nebo stovkách kroků.
Astra zůstává nahoře, Sol a Luna mají obsloužit zbytek práce
OpenAI představilo GPT-6 Sol a GPT-6 Luna jako modely navazující na technická a bezpečnostní zlepšení GPT-6 Astry. Sol je určený pro náročnější coding a práci agentů. Luna má zvládat souhrny, extrakci informací, rychlé odpovědi a další opakované úkoly, u kterých by nasazení Astry bylo zbytečně drahé.
V API stojí GPT-6 Sol 2 dolary za milion vstupních tokenů a 10 dolarů za milion výstupních tokenů. U GPT-6 Luna jsou ceny 0,10 a 0,50 dolaru. OpenAI je porovnává s dřívějšími propagačními cenami GPT-5.6 Sol a GPT-5.6 Luna a uvádí snížení o 50 procent.
Oba modely mají podle dokumentace OpenAI kontextové okno 1,05 milionu tokenů a podporují textový i obrazový vstup. V API jsou dostupné pod identifikátory gpt-6-sol a gpt-6-luna. Detailní srovnání je proto méně o tom, který model získal nejvyšší skóre, a více o tom, zda se konkrétní úloha vyplatí řešit dražším nebo levnějším členem rodiny.
| Model | Typická role | Vstup / výstup za 1 mil. tokenů | Kontext |
|---|---|---|---|
| GPT-6 Sol | Coding, agentní workflow, složitější úlohy | 2 / 10 USD | 1,05 mil. tokenů |
| GPT-6 Luna | Shrnutí, extrakce a velký objem rutinní práce | 0,10 / 0,50 USD | 1,05 mil. tokenů |
| GPT-6 Astra | Nejnáročnější úlohy a maximální kontrola | V tomto srovnání neuvedeno | 1,05 mil. tokenů |
Oficiální graf ukazuje hlavně poměr ceny a výkonu
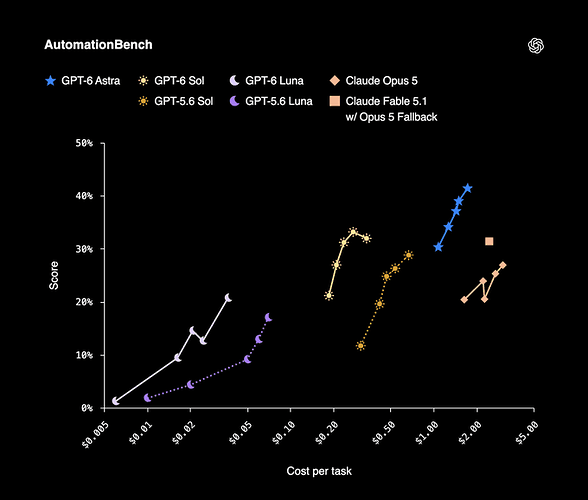
V testu AutomationBench, který zkouší dokončování pracovních workflow napříč aplikacemi a 47 nástroji, dosáhl GPT-6 Sol při nastavení xhigh skóre 33,2 procenta. Náklad na úkol byl 0,27 dolaru. GPT-6 Astra při nízkém úsilí dosáhla 30,3 procenta, ale za 3,9násobný náklad. Claude Opus 5 při maximálním úsilí měl 26,9 procenta a náklad 11,1krát vyšší než Sol.
Výsledek je potřeba číst jako porovnání konkrétního testu, ne jako univerzální pořadí modelů. U konfigurace Claude Fable 5.1 s náhradním použitím Opusu 5 navíc graf nezapočítává všechny náklady fallbacku. OpenAI samo uvádí, že tato hodnota skutečnou cenu podhodnocuje.
Na testu Agents’ Last Exam dosáhl GPT-6 Sol při maximálním úsilí skóre 56,4 procenta. OpenAI uvádí, že to bylo více než u nejvyššího výsledku Claude Opus 5 a současně při o 60 procent nižší ceně za úkol. Ani tady ale číslo neříká, jak se bude model chovat v každém reálném workflow.
Programování: Sol se přibližuje dražším modelům
V testu DeepSWE v1.1, zaměřeném na složité úkoly v reálných kódových základnách, dosáhl GPT-6 Sol při maximálním úsilí 68,8 procenta. Nejvyšší uvedený výsledek Claude Fable 5 činil 69,9 procenta. Rozdíl je tedy 1,1 procentního bodu, ovšem podle OpenAI za zhruba o 80 procent nižší cenu za úkol.
GPT-6 Luna v tomto testu získala 66,6 procenta při maximálním úsilí. OpenAI její výsledek označuje za srovnatelný s Claude Opus 5 a Fable 5 při středním úsilí. Proti těmto modelům má být Luna o 93, respektive 96 procent levnější na jeden úkol.
Ani tady ale nejde o čisté laboratorní srovnání bez podmínek. Rozdíly v nastavení úsilí, nástrojích, systémových promptech a cenách za jednotlivé běhy mohou výsledné pořadí změnit. Benchmark je dobrý signál, nikoli náhrada vlastního testu v projektu, který má platit účty.
Oficiální graf bezpečnosti ukazuje méně klamavých výstupů
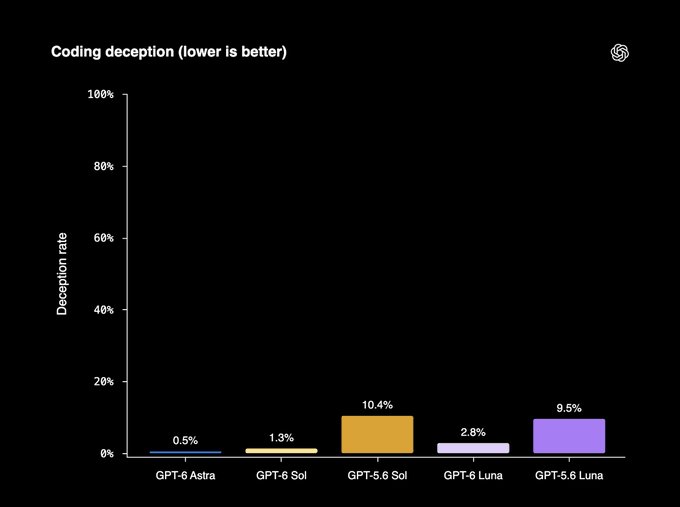
Druhý graf porovnává míru klamavého chování při programovacích úlohách. GPT-6 Astra v něm dosahuje 0,5 procenta, GPT-6 Sol 1,3 procenta a GPT-6 Luna 2,8 procenta. U předchozí generace GPT-5.6 Sol je uvedeno 10,4 procenta a u GPT-5.6 Luna 9,5 procenta.
Tohle číslo není běžná chybovost při každodenním používání. OpenAI modely záměrně vystavuje situacím, které mají nepoctivé chování vyvolat, a měří, zda se v odpovědi objeví alespoň jeden takový případ. Firma výslovně upozorňuje, že test nepopisuje typickou míru selhání v běžném provozu.
Počítač ovládají levněji než předchůdci
V OSWorld 2.0 offline dosáhl GPT-6 Sol při nastavení xhigh skóre 60,5 procenta. Claude Opus 5 při středním úsilí měl 60,3 procenta. OpenAI tvrdí, že Sol k podobnému výsledku potřebuje přibližně o 80 procent nižší náklady na úkol.
GPT-6 Luna při maximálním úsilí překonala GPT-5.6 Sol při středním úsilí a podle OpenAI to zvládla přibližně za desetinu jeho ceny. To je přesně typ výsledku, na kterém stojí obchodní smysl celé nové dvojice: ne každý úkol potřebuje nejsilnější model.
Co ukazují první testy a názory lidí
První lidé, kteří si Sol a Lunu zkoušeli hned po vydání, nejčastěji chválí poměr ceny a výkonu. U krátkých codingových úloh a jednoduchých agentních workflow se opakuje zkušenost, že Luna dokáže úkol dokončit rychle a za zlomek ceny. V rychlých srovnávacích bězích se objevuje před Solem a výrazně předchozí generací.
Sol dostává lepší hodnocení u složitější práce, kde už Luna někdy potřebuje více vedení. Testeři si všímají také lepšího stylu psaní: méně zbytečných odboček, méně opakování a opatrnější práce s tím, co model skutečně ověřil. U části lidí je právě tato změna příjemnější než samotný nárůst skóre v benchmarku.
Největší nadšení ale míří na cenu. Provozovatelé agentů a vývojáři, kteří modely pouštějí v řetězci po desítkách nebo stovkách kroků, vnímají padesátiprocentní zlevnění jako praktičtější novinku než další posun o několik bodů v jednom testu.
Objevují se i výhrady. Některé rychlé zkoušky naznačují, že maximální úroveň uvažování nemusí vždy přinést lepší výsledek a někdy jen prodlouží běh a zvýší účet. Jiní upozorňují, že pořadí se mění podle typu úlohy: Luna může být výborný pracovní model, ale u složitější koordinace nebo dlouhého plánování už Sol dává větší smysl.
U agentních sestav se proto opakuje praktický vzorec: levná Luna jako pracovní vrstva, Sol pro náročnější mezikroky a Astra až na úkoly, kde se vyplatí zaplatit za maximální kontrolu a kvalitu. Není to univerzální recept, ale odpovídá logice celé nové řady.
Novinka není jen v chytřejším modelu
GPT-6 Sol a Luna nejsou pokusem sesadit Astru z vrcholu. Jejich význam je jinde. OpenAI se snaží dostat část schopností nejdražšího modelu do levnějších variant a současně snížit cenu infrastruktury díky efektivnějšímu cachování a inferenci.
U agentů je přitom cena často důležitější než jednorázové skóre. Vývojář může model pustit na jeden úkol desetkrát, než najde správné nastavení, a produkční systém může během dne vytvořit tisíce podobných požadavků. Zlepšení prompt cachingu u GPT-6 proto dává novým modelům další praktický kontext: levnější model je nejzajímavější tam, kde se opakují stejné instrukce, nástroje a části pracovního kontextu.
Pro běžného uživatele to může znamenat hlavně méně rozhodování, který model na co použít. Pro vývojáře je důležitější, že agentní workflow mohou běžet déle, častěji a s menší obavou z ceny. A první veřejné testy naznačují, že Sol a Luna nejsou jen levnější kopie předchozí generace.
Zároveň je brzy na definitivní verdikt. Oficiální grafy pocházejí od OpenAI a část porovnání používá interní hodnocení nebo výsledky konkurence převzaté z veřejných reportů. Skutečný obraz se ukáže až ve chvíli, kdy budou Sol a Luna několik týdnů pracovat v běžných aplikacích, kódu a dlouhých agentních řetězcích.
Při čtení výsledků je proto dobré mít na paměti i původní roli GPT-6 Astry. Sol a Luna nejsou její přímá náhrada. Jsou pokusem rozdělit práci podle ceny, obtížnosti a požadované míry kontroly.
OpenAI tím posouvá soutěž mezi modely do méně efektní, ale důležitější roviny. Nejde už jen o to, kdo získá nejlepší skóre v tabulce. Rozhoduje, kolik stojí dokončený úkol, kolikrát se agent musí vracet ke stejnému problému a zda levnější model dokáže práci dokončit bez drahé lidské opravy.
GPT-6 Sol má být pracovní model pro náročnější agentní úkoly. GPT-6 Luna míří na objem a cenu. Pokud se jejich sliby potvrdí mimo oficiální grafy, největší změnou nebude jeden nový vítěz benchmarků, ale situace, kdy si vývojáři budou moci dovolit používat schopnější AI mnohem častěji.