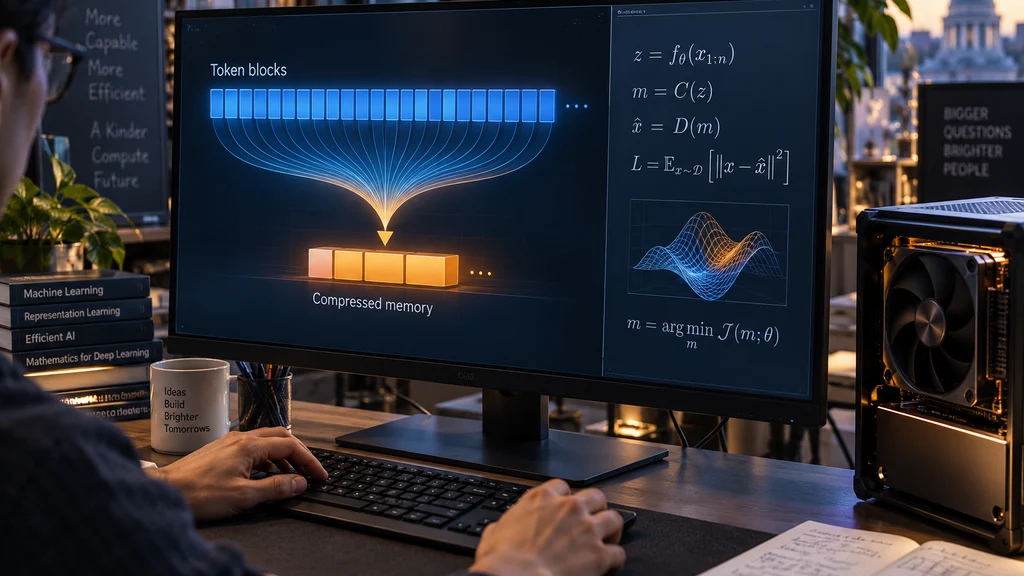
Výzkumníci zveřejnili AbridgeKV, postup pro snížení paměťových nároků dlouhého uvažování jazykových modelů. Po každém bloku 512 vygenerovaných tokenů model vloží naučené pauzové tokeny. Ty shrnou informace z bloku do jeho pracovní paměti, takže původní záznamy lze uvolnit. Další generování pak využívá jejich komprimovanou reprezentaci místo celé dosavadní posloupnosti.
Autoři metodu zkoušeli na dotrénovaném Qwen3-4B-Base a sadě 446 matematických úloh. Uvádějí průměrný výsledek 43 procent proti 43,8 procenta u plné paměti. V jejich nasazení přes vLLM byla paměť na sekvenci 3,5krát menší a vytížená H100 dokončila úlohu 3,2krát rychleji. Jde o výsledky konkrétního experimentu, ne univerzální zrychlení libovolného modelu. Kód, vyhodnocovací postupy a záznamy měření jsou dostupné v repozitáři.