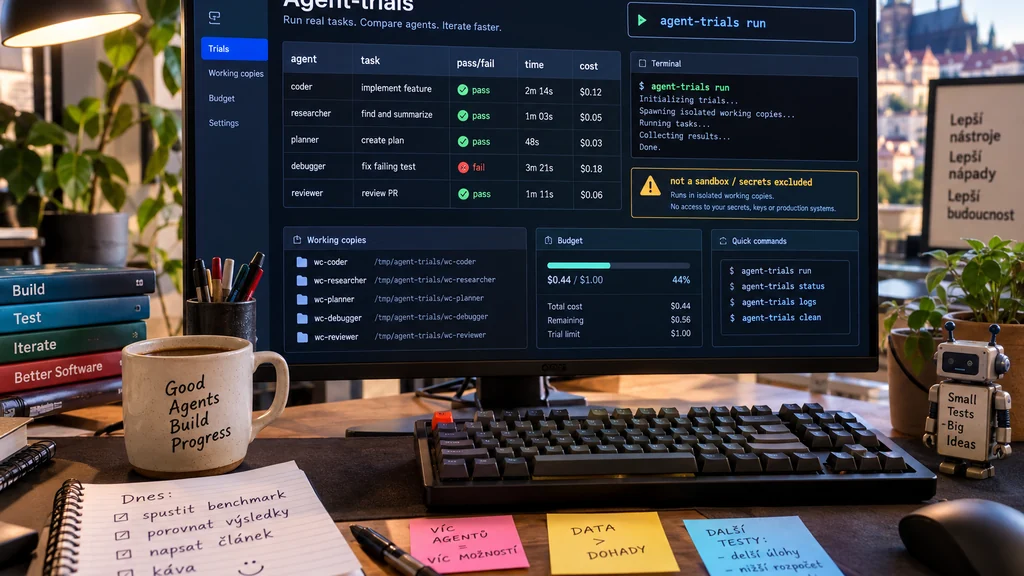
Agent-trials chce nahradit obecný benchmark praktickou zkouškou nad vlastním repozitářem. README říká, že nástroj pustí stejnou sadu úkolů přes různé CLI coding agenty a vytiskne scoreboard s výsledkem, časem a cenou. Každý úkol běží v dočasné working copy, zatímco příkazy se stále spouštějí na hostiteli. Proto dokumentace zdůrazňuje bezpečnostní omezení: agenti nedostanou běžné tajné proměnné prostředí, nekopírují se .env, klíče, .ssh nebo .npmrc a symlinky se přeskakují. Smyslem je ověřit, zda konkrétní agent zvládá chyby ve vašem stacku, ne vyhrát univerzální žebříček. Konfigurace podporuje vlastní úkoly, kontrolní příkazy a rozpočet pro srovnání nákladů mezi jednotlivými běhy. Nejde o sandbox; autor doporučuje jednorázový virtuální stroj bez citlivých dat.