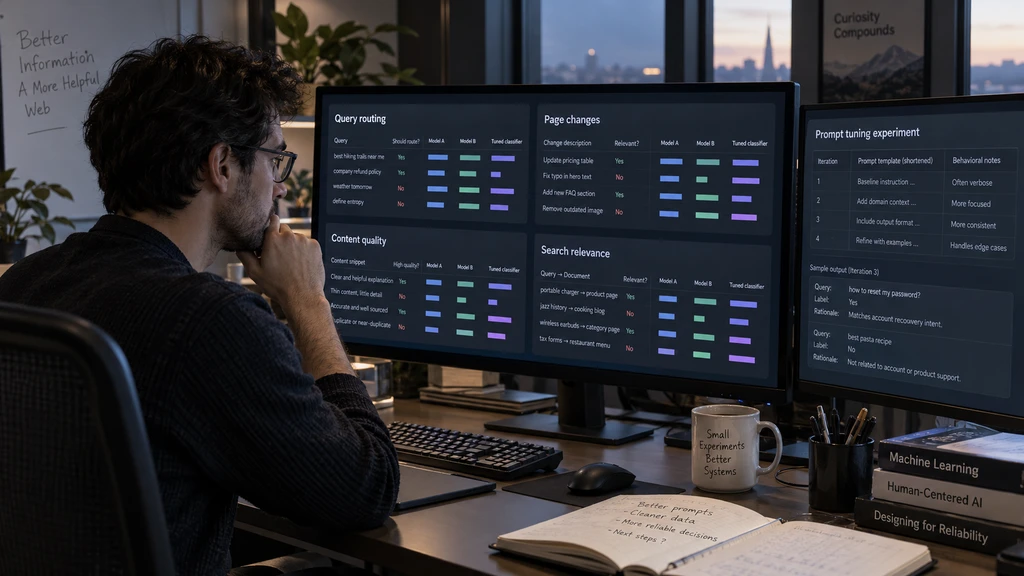
Parallel zveřejnilo srovnání osmi rozhodovacích modelů na čtyřech úlohách ze svých produkčních postupů. Testovalo řazení výsledků vyhledávání, rozpoznání významných změn stránky, filtrování nekvalitního obsahu a směrování dotazů. Jev se osvědčil jako vyvážená výchozí volba, některé otevřené modely ale dosahovaly srovnatelné kvality. Specializovaný vlastní model firmy překonal nejlepší rozhodovací model v řazení výsledků o 3,8 procentního bodu. Pět kol úprav promptů podle označených příkladů navíc v některých případech výrazně zlepšilo výsledky bez trénování vah. Nejde o univerzální žebříček: pořadí se měnilo podle úlohy a vlastní provoz otevřených modelů přidává náklady na infrastrukturu. Firma doporučuje výběr ověřit na vlastních označených datech.