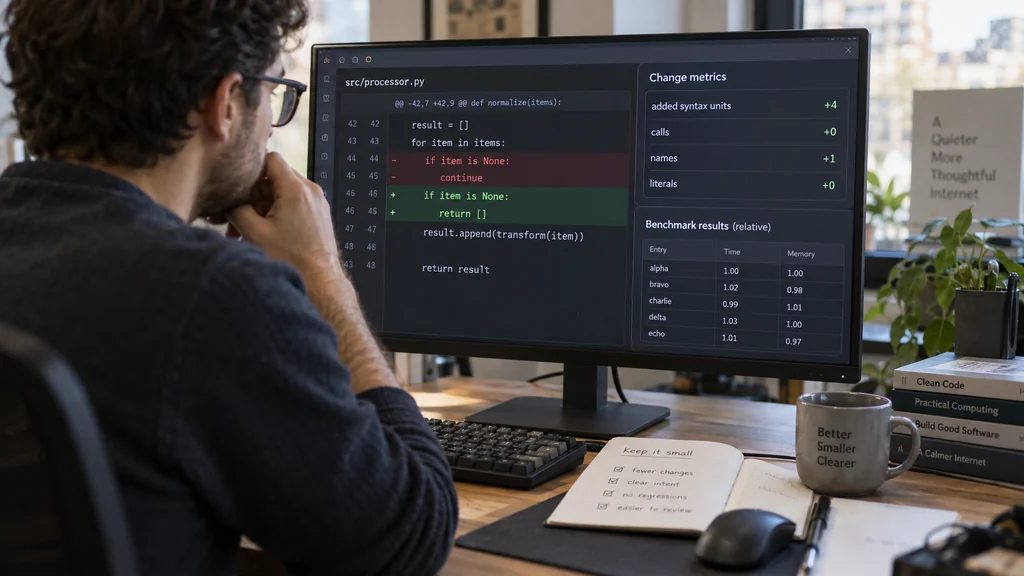
Parsimony představuje open-source benchmark, který sleduje nejen úspěšnost kódovacích agentů, ale také množství přidaného kódu. Zpracovává veřejné patche z DeepSWE, SWE-bench Verified a SWE-bench Live a počítá syntaktické jednotky: příkazy, volání, názvy a literály. Formátování, komentáře nebo délka názvů se do výsledku nepromítají. Žebříček řadí modely podle průměrné čisté změny u úspěšně vyřešených úloh a vedle ukazuje úspěšnost i další pokusy. Patche se při měření nespouštějí. Každý jazyk a benchmark má vlastní tabulku, protože čísla nejsou mezi nimi přímo srovnatelná. Méně kódu samo o sobě neznamená lepší opravu; projekt nabízí doplňkový pohled na budoucí náročnost údržby, nikoli náhradu funkčních testů.