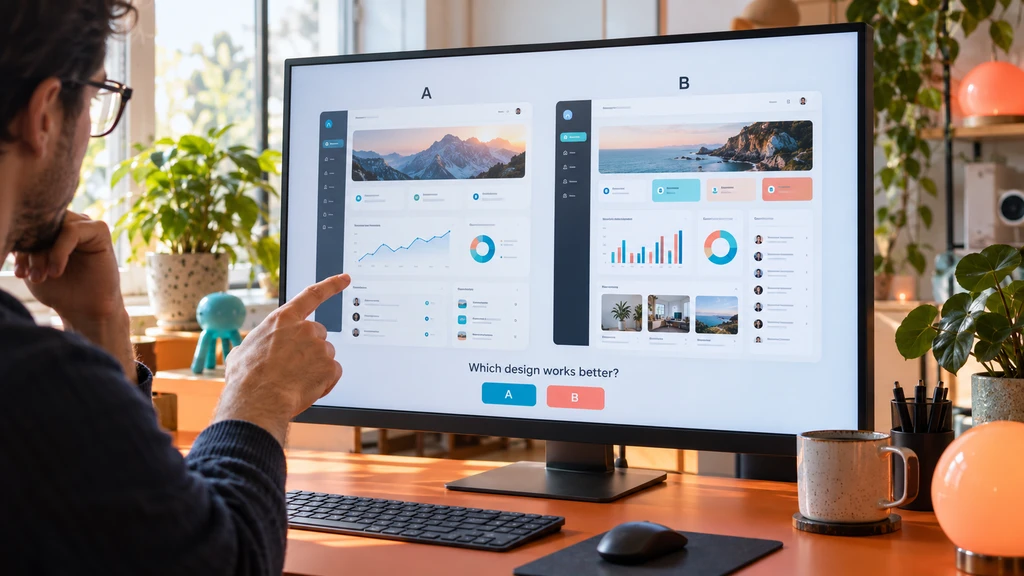
Real Design Benchmark porovnává návrhy nových funkcí vytvořené AI s obrazovkami skutečných webových produktů. Model dostane slovní zadání, jiné části aplikace a její vizuální styl, ale nesmí vidět hodnocenou původní obrazovku. Návštěvníci pak naslepo vybírají lepší návrh a teprve poté odhadují, který vytvořila AI.
Zveřejněná metodika zahrnuje 116 úloh z 52 produktů a sestavy s Claude Opus 5.5 a GPT-6.1 Sol. Výsledky se počítají z jednotlivých kol, nikoli z počtu lidí. Účastníci se vybírají sami a častí hráči mají vyšší váhu, nejde proto o reprezentativní průzkum. Statické snímky navíc neověřují funkčnost, přístupnost ani kvalitu kódu. Projekt podporuje Subframe a popisuje omezení i postup kontroly zadání.