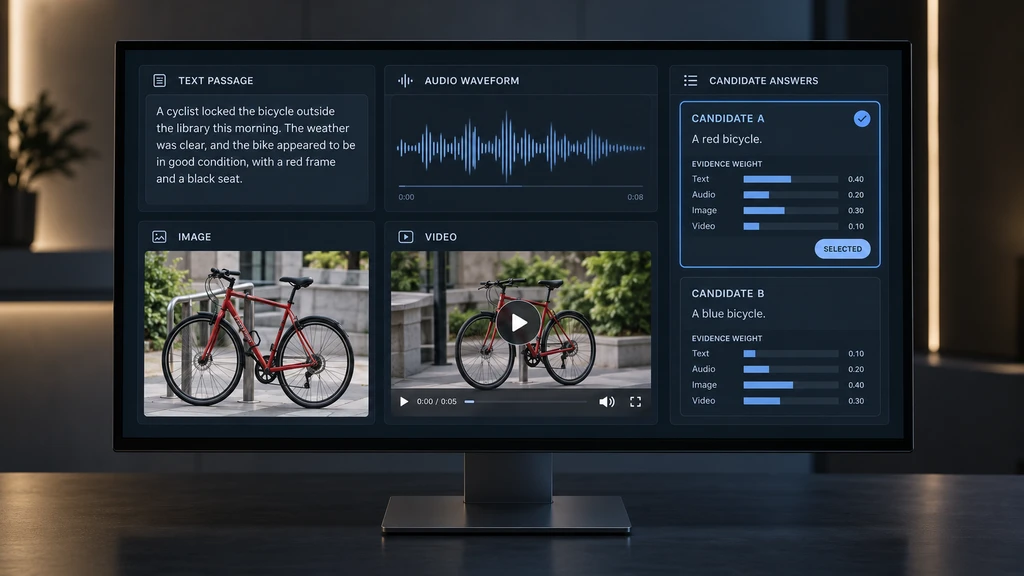
SpragAI zveřejnil SPEV, model pro multimodální rozhodovací úlohy s otevřenými vahami. Vychází z Qwen3-Omni-30B-A3B a doplňuje jej trénovaným LoRA adaptérem a rozhodovací hlavou. Místo dlouhé volné odpovědi hodnotí dodané možnosti v jednom průchodu a vrací pravděpodobnosti i nejlépe hodnocenou variantu. Vstupy mohou kombinovat textový kontext, zvuk, obraz a video.
Ukázka řeší například to, zda poslední mluvčí už předal slovo, nebo má hlasový asistent dál poslouchat. Model je dostupný s licencí Apache 2.0. Zveřejněné srovnání latence používá konkrétní hardware a malý počet testovaných příkladů, takže nevypovídá o přesnosti rozhodování ani univerzální rychlosti. Nasazení navíc používá vlastní implementaci modelu, jejíž kód musí provozovatel před spuštěním posoudit.