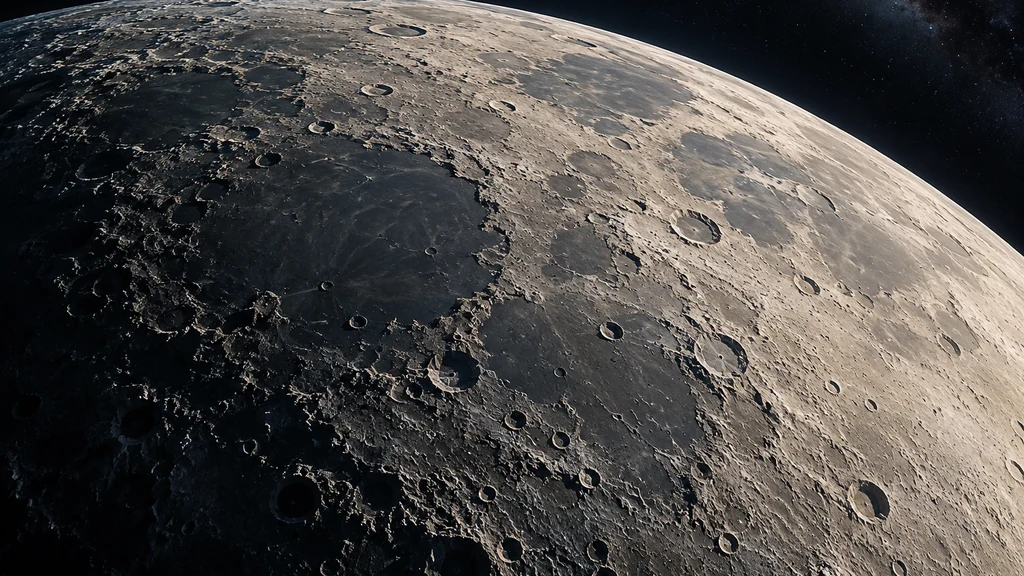

Většina AI novinek se dnes snaží přesvědčit člověka, že další chatbot vyřeší další problém. NASA a IBM zvolily méně efektní, ale možná důležitější cestu: vzaly desetiletí pozorování Měsíce a postavily model, který se učí hledat vztahy mezi různými druhy měření. Neodpovídá na otázky o počasí ani nepíše básně o Apollu. Má pomoct vědcům číst povrch našeho souputníka jako jeden propojený systém.
Na Radyzu jsme o projektu psali už v rychlé zprávě o otevřeném modelu NASA a IBM pro lunární data. Delší pohled ale ukazuje, proč je tenhle případ zajímavější než další tisková zpráva o modelu, který je „až o něco lepší“ v jedné tabulce. Podstatná není jen přesnost. Podstatné je, co se stane, když se obraz, topografie, radar, osvětlení a další vrstvy přestanou zpracovávat odděleně.
Měsíc není jedna fotografie
Lunární mise po desetiletí vytvářely obrovské množství dat. Každý přístroj se ale dívá na jinou vlastnost povrchu, v jiném rozlišení, s jinou geometrií a podle jiných pravidel. Kamera ukáže strukturu terénu, topografická mapa jeho výšku, měření osvětlení prozradí, co se děje ve stínu, radar a gravitační data zase přidají informace, které na běžném snímku neuvidíte.
Člověk může tyto vrstvy porovnávat ručně nebo je zpracovávat pomocí úzce zaměřených modelů. Právě tady má strojové učení šanci ušetřit práci, ne ji jen přesunout do jiné tabulky. To je ale přesně ten typ práce, při kterém se věda snadno utopí v přípravě dat. Problém není jen v objemu. Různé mapy je potřeba prostorově zarovnat, správně interpretovat a nepředstírat, že měření s rozlišením jednoho metru říká totéž co vrstva s rozlišením stovek metrů.
NASA-IBM Lunar Foundation Model vznikl jako pokus tento problém obejít společným základem. Jde o foundation model pro lunární dálkový průzkum, který se předtrénoval od začátku na různých měsíčních datech místo toho, aby se jednoduše převzal model naučený na pozemských fotografiích.
SomBench: méně kouzel, více srovnatelnosti
Základem je datová sada SomBench, která podle odborného článku na arXivu obsahuje téměř dva miliony společně registrovaných balíčků v 11 modalitách a dvou prostorových měřítcích – přibližně jeden metr a sto metrů na pixel. Projekt tedy pracuje s datovou sadou, která není jen hromadou obrázků, ale pokusem o prostorově sladěný popis Měsíce. Druhá práce popisuje více než 30 prostorově zarovnaných vrstev z deseti přístrojů a čtyř misí. Čísla se liší podle toho, zda se mluví o předtrénovacích balíčcích, nebo o širším souboru vrstev a zdrojů.
Tohle rozlišení není akademická drobnost. U AI projektů se často vezme jedno velké číslo, přilepí se k němu slovo „multimodální“ a zbytek se nechá na marketingu. Tady je zajímavější samotná snaha vytvořit jednotný, strojově použitelný základ pro data, která původně vznikala v různých misích a pro různé účely.
SomBench zároveň slouží jako benchmark pro úlohy, na kterých lze modely porovnávat. Výzkumníci testovali detekci kráterů v regionálním i metrovém měřítku, segmentaci obrazu nepravidelných mareových útvarů a odhad pravděpodobnosti výskytu ledu v polárních oblastech. Součástí datasetu je také detailní kráterový benchmark z kamer LROC NAC, v němž bylo ručně označeno více než 49 tisíc kráterů.
Co model podle zveřejněných výsledků zvládá
NASA, IBM a USRA uvádějí, že předtrénovaný model ve třech hlavních úlohách dosáhl nejméně srovnatelných výsledků s modely předtrénovanými na ImageNetu a s architektonicky stejným modelem bez lunárního předtrénování. To je důležité srovnání: nejde pouze o otázku, zda model funguje, ale zda mu specializovaná znalost Měsíce skutečně něco přidává.
IBM ve svém oznámení uvádí až 22procentní zlepšení při odhadu oblastí s vyšší pravděpodobností lunárního ledu proti konkrétnímu modelu SwinV2-B s předtrénováním na ImageNetu. U segmentace nepravidelných mareových útvarů uvádí tříprocentní zlepšení a u detekce kráterů v kontextovém měřítku téměř 19 procent při použití poloviny trénovacích dat. Tato čísla je fér číst jako výsledky konkrétních experimentů, ne jako obecný slib, že model bude o 22 procent lepší na všem.
Výzkumný článek navíc upozorňuje na rozdíly mezi úlohami. Předtrénování pomáhá zejména u některých úloh s menším množstvím popsaných dat, zatímco u odhadu ledové perspektivity může nejlépe vycházet plné doladění. I LoRA – technika, která umožňuje upravovat jen malou část parametrů – v některých úlohách dosahuje srovnatelných nebo lepších výsledků než plné doladění. V praxi to znamená, že výzkumníci nemusí pokaždé trénovat celý model od nuly.
Nejde jen o hledání kráterů
Krátery jsou pro lunární vědu něco jako letokruhy pro strom. Jejich rozložení a velikost pomáhají odhadovat stáří povrchu, rekonstruovat historii dopadů a plánovat bezpečnější místa pro přistání. Model, který zvládne spojit obraz s terénem a dalšími vrstvami, může hledat útvary rychleji a v kontextu, který by při práci s jediným snímkem zůstal skrytý.
Podobně je to s nepravidelnými mareovými útvary, které souvisejí s vulkanickou historií Měsíce, nebo s polárními oblastmi ve stálém stínu. Led tam není jen vědecká zajímavost. Voda může být jedním z klíčových zdrojů pro budoucí dlouhodobý provoz na Měsíci – pro pití, výrobu kyslíku i potenciální výrobu paliva. Model samozřejmě žádný led nevykopal. Pomáhá pouze odhadovat, kde má smysl hledat podrobněji.
Právě v tom je rozdíl mezi modelem pro vědeckou analýzu a chatbotem. Chatbot umí působit chytře v konverzaci, ale jeho výstup často stojí na pravděpodobném pokračování textu. Lunární model má jinou práci: spojovat měření, zachovat prostorový kontext a dávat výsledek, který lze porovnat s daty a následně ověřit.
Otevřenost je důležitější než logo na titulní straně
NASA a IBM uvolnily předtrénovaný model, kód pro doladění a benchmarková data. Dostupné jsou přes kolekci na Hugging Face. Výzkumníci tak nemusí začínat od prázdného repozitáře ani si vystačit s popisem výsledků v tiskové zprávě.
To neznamená, že otevřený model automaticky vyřeší problémy lunární vědy. Otevřenost závisí také na kvalitě dokumentace, dostupnosti dat, podmínkách použití a schopnosti zopakovat experiment. Ale sdílený základ mění ekonomiku výzkumu. Univerzitní tým může vzít hotový checkpoint, doladit ho pro jinou úlohu a soustředit čas na vědeckou otázku místo opakování celé infrastruktury.
Je to podobná změna, jakou přinesly otevřené modely v jiných oborech, jen s menší mediální hlučností. Místo jednoho obecného systému pro všechno vzniká model, který je opravdu užitečný proto, že respektuje vlastnosti konkrétní domény. Měsíc je v tomhle směru dobrá testovací laboratoř: dat je hodně, jsou různorodá a chybná interpretace může znamenat špatný vědecký závěr, ne jen trapnou odpověď v chatu.
Největší test teprve přijde
Publikované výsledky zatím ukazují slibný základ, nikoli hotového autopilota pro lunární výzkum. Model byl hodnocen na vybraných úlohách a srovnávaných metodách. To je nutný začátek, ale ne důkaz, že si poradí s každým přístrojem, každým typem terénu nebo s daty z budoucích misí.
Otázkou bude také přenositelnost. Model se učil z konkrétních měsíčních datasetů a jejich způsobu zarovnání. Jak se zachová při změně přístroje, rozlišení nebo podmínek měření? A jak dobře se bude rozhodovat v místech, která jsou v trénovacích datech zastoupena málo? Vědecký model může být otevřený a přesto může vytvářet přesvědčivé chyby, pokud uživatel nerozumí jeho slepým místům.
Přesto je směr správný. Nejzajímavější část projektu není představa, že AI sama objeví tajemství Měsíce. Zajímavé je, že se vědci pokusili postavit společný jazyk pro data, která spolu dosud často mluvila jen přes komplikované převodníky. Pokud se podobný přístup osvědčí, další modely nebudou muset začínat u chatbotových triků, ale u fyzického světa, který má měřitelná pravidla.
A to je možná užitečnější definice pokroku v AI než další demo s hlasem a avatárem. Model, který pomůže lépe přečíst Měsíc, sice nebude tak snadné prodat na sociálních sítích. Vědě by ale mohl ušetřit roky práce – a právě tam se nakonec ukáže, jestli otevřená AI opravdu něco umí.